
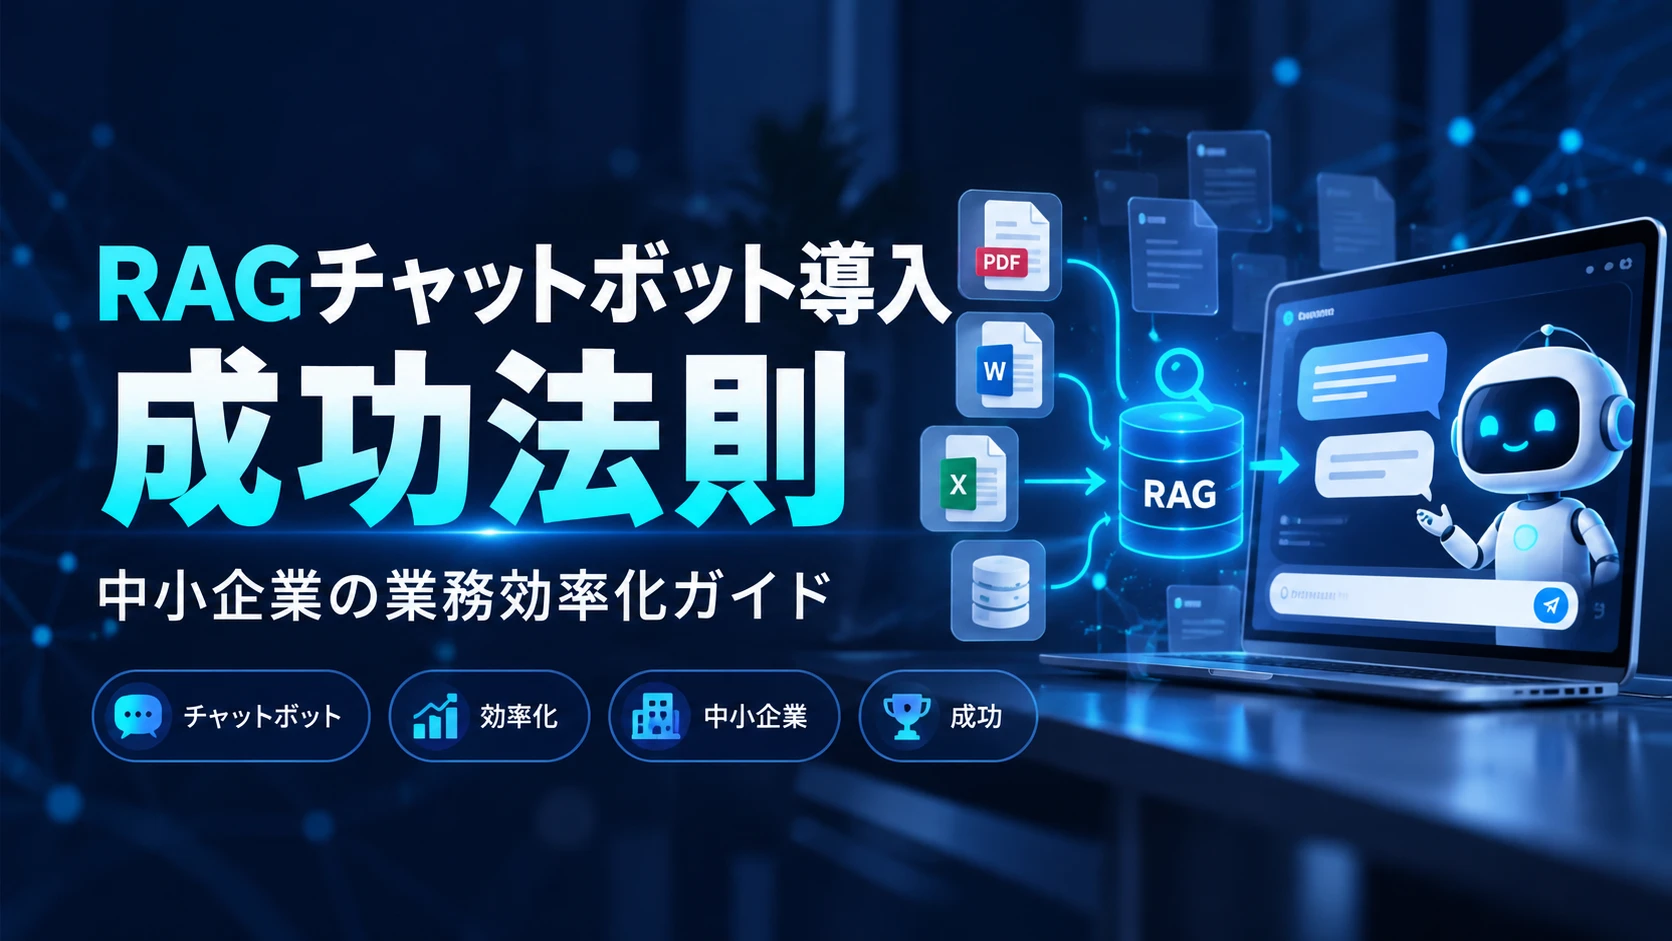
社内に眠る膨大な資料やマニュアルを、生成AIで活用したいと考えていませんか。最新の技術である「RAG(検索拡張生成)」を活用したチャットボットは、企業独自のデータに基づいた正確な回答を実現する強力なツールです。本記事では、AI導入支援を専門とするXAIがRAGの仕組みを解説します。あわせて、導入に不可欠な「データの質」の重要性や、九州の現場で成果を出すための現実的な進め方についても紹介します。
RAGチャットボットとは何か:生成AIと社内データの架け橋
企業における生成AIの活用は急速に進んでいますが、多くの経営者が直面する壁が「AIは自社固有の事情を知らない」という問題です。ChatGPTのような汎用的なAIはインターネット上の膨大な公開情報を学習していますが、社外秘のマニュアルや最新の社内規定、個別の顧客対応履歴までは把握していません。
この課題を解決する技術が「RAG(検索拡張生成)」です。RAGは、AIモデル自体を再学習させることなく、外部の社内データベースやドキュメントを一時的に参照させることで、自社独自の知識に基づいた回答を可能にします。これにより、AIは単なる「物知りなチャットボット」から、貴社の業務を深く理解した「頼れる社内アシスタント」へ進化します。
汎用AIとRAGチャットボットの違い
| 比較項目 | 汎用生成AI | RAGチャットボット |
|---|---|---|
| 回答の根拠 | 学習済みの公開データ | 社内ドキュメント・データベース |
| 社内情報の活用 | 不可 | 可能 |
| 専門性・独自性 | 低い(一般的) | 高い(自社特化) |
| 最新情報の反映 | 学習が必要(遅い) | 即時反映可能 |
RAGの基本原理と強み
RAG(Retrieval-Augmented Generation)の仕組みを理解するために、「図書館の優秀な司書」をイメージしてください。
まず、ユーザーがチャットボットに質問を投げかけると、システムは即座に社内の資料棚(データベース)から、その質問に関連するページを検索します。次に、見つけ出した資料の断片を、生成AIに対して「この資料を参考にして、質問に答えてください」と提示します。AIはその資料を読み込み、内容を要約・整理して回答を作成します。
このプロセスの最大の強みは、AIが「自分の知っていること」だけで話すのではなく、「提示された根拠」に基づいて回答することです。これにより、AIが勝手な推測で嘘をつくリスクを抑えつつ、社内の膨大なドキュメントから必要な情報を瞬時に引き出せます。
汎用AIとの決定的な違い
汎用AIとRAGチャットボットの決定的な違いは、「情報の鮮度」と「情報の限定性」にあります。
汎用AIは事前に膨大なデータを学習してモデルを構築するため、一度回答を生成すると、その知識を後から簡単に入れ替えられません。そのため、昨日更新されたばかりの社内ルールや、今朝共有された営業資料については回答することができません。
対してRAGは、AI本体を学習させる必要がありません。社内の共有フォルダやデータベースに最新のPDFやExcelファイルを保存しておくだけで、システムはその時点での最新情報を参照して回答を生成します。つまり、社内のナレッジが更新されれば、AIの回答も自動的に最新の状態に保たれるのです。この「情報の更新性」と「自社ドキュメントへの準拠」こそが、業務効率化に不可欠な要素です。
RAGチャットボットの導入を検討する際は、自社の業務プロセスに合わせたシステム設計が重要です。中小企業における具体的な導入の進め方については、中小企業のAIシステム開発:失敗しない導入の進め方を専門家が解説で詳しく解説しています。
導入成功の鍵はデータにあり:精度を左右する品質管理
RAGチャットボットの構築において、AIモデルの性能以上にプロジェクトの成否を分けるのが「読み込ませるデータの質」です。どれほど高性能なAIエンジンを採用しても、参照する元の社内文書が不正確であれば、当然ながら回答も不正確になります。特に、長年蓄積された紙資料や、担当者ごとに形式が異なるデジタルファイルが混在する環境では、AIが情報を正しく理解できないリスクが高まります。
データ準備は、単なる情報の移行作業ではなく、AIが活用しやすい形へと「整理」する重要なプロセスです。以下の表に、導入前に踏むべき基本的なデータ準備のステップをまとめました。
| ステップ | 内容 | 期待効果 |
|---|---|---|
| 棚卸し | 必要な文書と不要な情報の選別 | ノイズの削減と検索精度の向上 |
| クレンジング | 重複削除や誤字脱字の修正 | 回答の信頼性担保 |
| 構造化 | 章立てやメタデータの付与 | 文脈理解の促進と検索効率化 |
これらのステップを疎かにすると、AIが「関連性の低い情報」を拾い上げ、誤った回答を生成する確率が高まります。まずは自社が保有する情報の現状を把握し、優先順位をつけて整理していくことが、成功への第一歩です。
クレンジングと構造化の重要性
AIが社内文書を正確に読み解くためには、人間が読んで理解できる状態であることに加え、機械がパターンを認識しやすい状態に整える「構造化」が欠かせません。
具体的には、手書きのメモをデジタルテキスト化する、バラバラなファイル形式を統一する、古い版の資料を破棄して最新版のみを残すといった「クレンジング」が必須です。さらに、文書内に「見出し」や「タグ」を適切に付与することで、AIは情報の階層構造を正確に把握できるようになります。この下準備を徹底することで、検索時のヒット率が向上し、回答の「根拠」となる情報をより正確に抽出することが可能になります。
権限管理とセキュリティ設計
社内ナレッジを活用するRAGでは、「誰がどの情報にアクセスできるか」という権限管理が極めて重要な課題となります。例えば、人事評価に関する機密資料や経営層のみが閲覧すべき情報を、権限のない一般社員がチャットボットを通じて検索できてしまう事態は避けなければなりません。
導入にあたっては、既存の社内認証システムとAIシステムを連携させましょう。ユーザーの役職や部門に応じて検索対象を制限する設計が必要です。セキュリティを考慮しない安易な導入は、情報漏洩のリスクを招きます。システム開発の段階から「誰にどこまでの情報を開示するか」というガバナンスルールを明確に定義してください。安全な運用環境の構築が、企業が安心してAIを使い続けるための必須条件です。
導入で失敗しないための期待値管理と運用サイクル
RAGチャットボットの導入において、多くの企業が陥りがちな罠が「導入すればAIがすべてを完璧に解決してくれる」という過度な期待です。生成AIは確率的に文章を生成するシステムであり、万能ではありません。特に業務利用においては、AIの特性を正しく理解し、リスクを許容した上で、それを補完する仕組みを構築することが成功の絶対条件となります。
AI運用における主なリスクと対策を整理すると、以下のようになります。
| 項目 | リスク | 対策 |
|---|---|---|
| 回答の正確性 | ハルシネーション(嘘の生成) | 根拠情報の提示と参照元の明示 |
| 情報の鮮度 | 古いマニュアルに基づく回答 | 定期的なデータ更新と版管理フローの整備 |
| ユーザーの信頼性 | 不正確な回答による混乱 | 「分からない」と回答させる設定の導入 |
これらのリスクを管理し、継続的な運用サイクルを回すことが、現場で本当に役立つシステムへと育てる鍵となります。
ハルシネーションと向き合う設計
ハルシネーション(Hallucination)とは、AIが事実に基づかない情報を、あたかも真実であるかのように自信満々に回答する現象です。RAGは社内データを参照させることでこのリスクを大幅に低減できますが、完全にゼロにすることは困難です。そのため、導入時には「AIは嘘をつく可能性がある」という前提に立ち、リスクを最小化する設計が求められます。
具体的には、AIが回答を作成する際、必ず「参照した社内文書の該当箇所」を引用元として提示させる仕組みが有効です。これにより、ユーザーは回答が正しいかどうかを即座に確認できます。また、プロンプト設計において「社内データ内に回答が見当たらない場合は、推測で答えず『該当する情報が見つかりません』と回答するように」と明確に指示を出すことも重要です。このようなガードレールを設けることで、根拠のない回答が業務に紛れ込むリスクを抑えることができます。
導入後のPDCA体制
RAGチャットボットは、リリースした時点がスタートラインです。社内の業務ルールは日々変化し、参照すべきマニュアルも更新されます。そのため、導入して終わりではなく、回答の精度を維持・向上させるための運用体制が不可欠です。
まずは、ユーザーからの「回答が間違っていた」「期待した情報が出なかった」といったフィードバックを収集する仕組みを整えてください。これらのログを定期的に分析し、回答の根拠となる社内データベースの不足や、表現の曖昧さを修正していく「PDCAサイクル」を回すことが重要です。運用担当者が中心となり、現場の声を吸い上げてナレッジを更新し続ける体制こそが、AIを「使い物にならないツール」から「頼れる業務パートナー」へと進化させる唯一の道です。
AI導入に関する具体的な構想や、自社の業務課題に対する活用可能性について相談したい場合は、AI導入・AIシステム開発のご相談よりお気軽にお問い合わせください。
まとめ:九州の現場でAI活用を推進するために
RAGチャットボットの導入は、単なるITツールの導入ではなく、社内に眠るナレッジを資産化し、組織の働き方をアップデートする取り組みです。ここまで解説してきた通り、精度の高いAIを実現するためには、技術的な基盤だけでなく、整理されたデータと、継続的な運用改善のサイクルが不可欠となります。
九州の企業がAI活用で成果を出すためには、最初から完璧なシステムを目指すのではなく、現場の小さな課題を解決する「スモールスタート」が成功の鍵です。AIは導入して終わりではなく、活用を通じて現場のナレッジを蓄積し、共に成長していくパートナーとして捉えることが重要です。以下に、AI導入を成功に導くための標準的なロードマップをまとめました。
| フェーズ | 主なアクション | XAIの支援内容 |
|---|---|---|
| 1. 課題特定 | 業務の棚卸しと優先順位付け | 現場ヒアリングによる課題の可視化 |
| 2. 基盤構築 | データの整理・クレンジング | 最適なRAG構成の設計と構築 |
| 3. 運用開始 | 小規模な現場導入と評価 | ユーザーフィードバックの収集・分析 |
| 4. 改善・拡大 | ナレッジの更新と機能拡張 | 継続的なチューニングと運用伴走 |
自社に最適なAI活用の第一歩
AI導入を成功させるための第一歩は、技術の選定やツールの比較ではなく、自社の「どの業務を効率化したいのか」という課題の整理から始まります。例えば、「社内規定に関する問い合わせ対応を減らしたい」「技術資料の検索時間を短縮したい」といった、具体的かつ現場が困っているポイントを明確にすることが重要です。
最初から全社的な大規模システムを構築しようとすると、データ整備の負荷やコストが膨らみ、導入のハードルが高くなってしまいます。まずは特定の部署や特定の業務に絞り、小規模なPoC(概念実証)から始めることで、AIの特性や自社データとの相性を把握し、着実に効果を実感しながら運用範囲を広げていくのが最も現実的なアプローチです。
専門家とともに進めるAI推進
AI技術は日進月歩で進化しており、自社だけで最適な環境を構築・維持し続けるには高い専門性が求められます。また、現場の業務プロセスを深く理解していないシステム導入は、往々にして「使いにくいAI」を生み出す結果となります。
XAIでは、九州の中小・中堅企業の皆様が抱える現場の課題を共有いただき、技術と業務の両面から最適なAI活用を支援しています。具体的な仕様やシステム構成が決まっていなくても全く問題ありません。「社内にこのような書類はあるが、どう活用すればいいか分からない」「AIで本当に業務が楽になるのか相談したい」といった悩みベースのご相談から、私たちが伴走者としてサポートいたします。まずは貴社の現状をお聞かせいただき、共に成果が出るAI活用への第一歩を踏み出してみませんか。